 Simone
真实拟声的文本到语音 bert-vist2模型训练教学
的有关信息介绍如下:真实拟声的文本到语音BERT-VITS2模型训练教学如下:
工具和整合包准备:
准备所需的工具和整合包,包括各种软件和工具库,可从提供的百度网盘链接下载:https://pan.baidu.com/s/1iQtzpioz8MX2hF7EWeYluA?pwd=gvvy。
音频处理工具推荐:
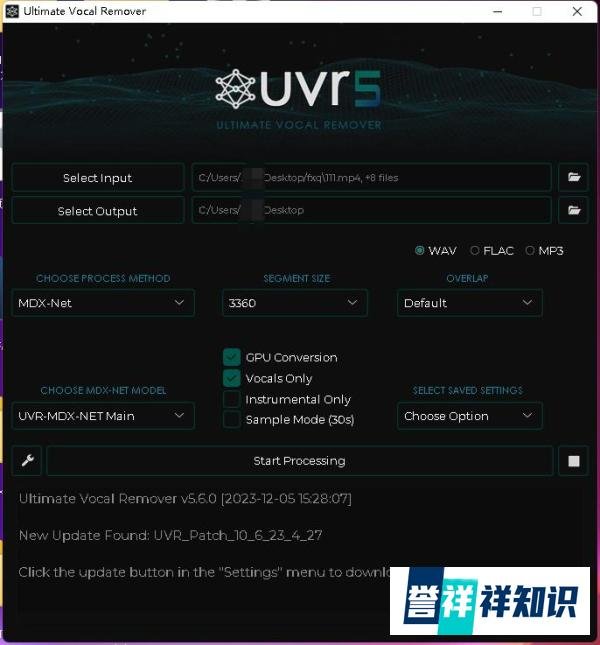
使用UVR工具进行声音提纯,去除背景音和杂音。
数据集准备选项:
直接下载优化模型:在模型工坊中下载已经训练好的声音模型,如bert-vits2.1懒羊羊声音模型,这些模型已经经过精细优化,可直接导入使用。
自行训练声音模型:根据以下步骤进行操作。
声音素材提纯:
使用UVR工具对训练声音素材进行提纯处理,去除背景音和杂音。
声音素材切片:
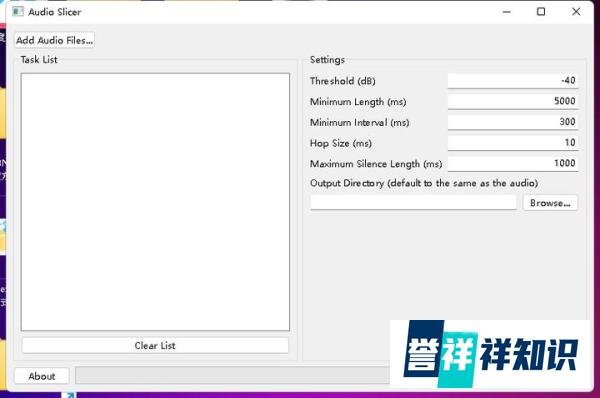
对音频进行切片,以便后续处理。
文本标注:
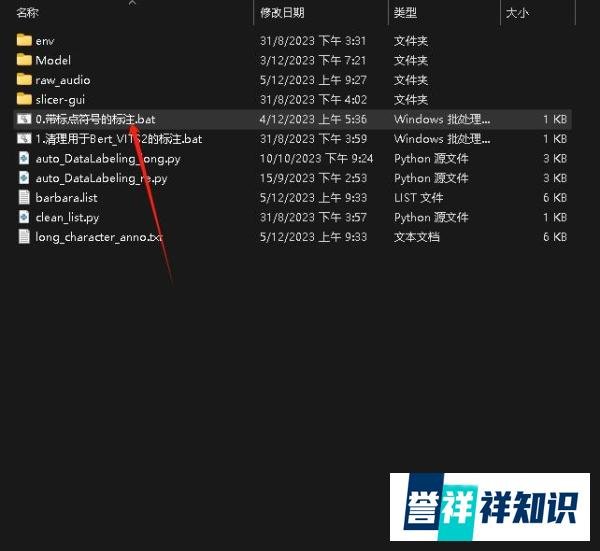
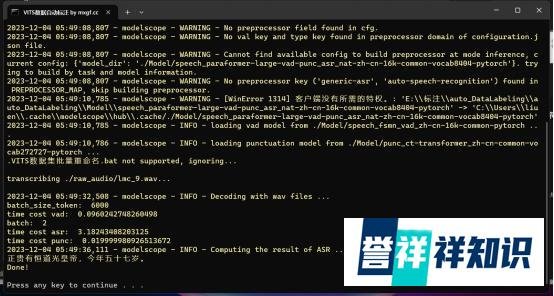
对切片好的音频进行文本标注,切片好的音频经过手动筛选过短的音频放入raw_audio,点击0.带标点符号的标注进行文本标注。
标注完成示例:
数据集筛选:
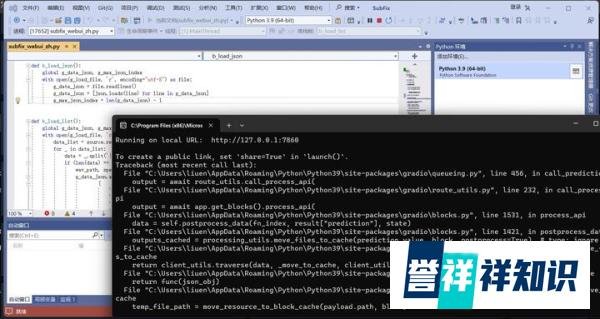
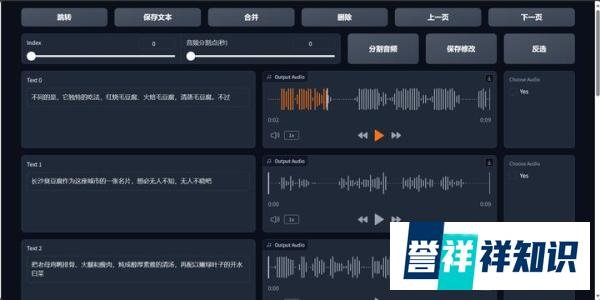
使用开源工具SubFix(https://github.com/cronrpc/SubFix)对标准的文本和处理好的音频数据集进行进一步的筛选。
本项目适配Bert-Vits2的list文件的标注格式,可以轻松添加到已有的自动标注数据处理的工作流中,或者使用本项目自带的一个音频自动标注方法,之后再进行精修。
创建文件夹与启动webui:
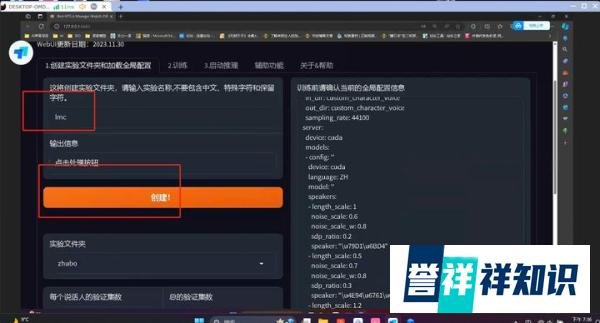
打开bert-vits2整合包,启动webui,创建训练的模型目录。
文件放置:
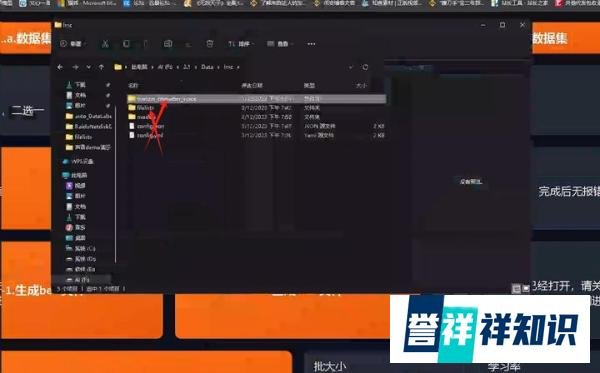
将切好片的声音文件放入custom_character_voice文件夹。
将标注好的文本放入filelists文件夹。
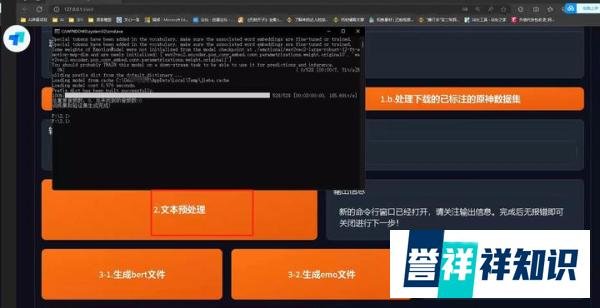
文本预处理:
进行文本预处理,为后续生成bert和emo文件做准备。
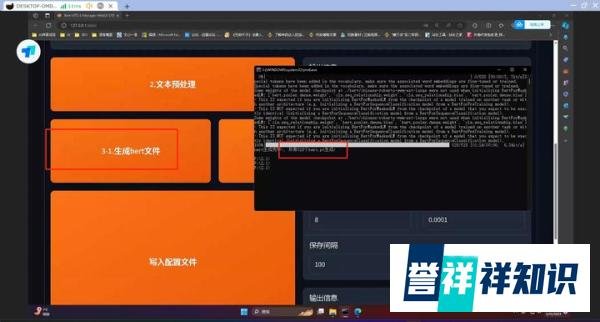
生成bert文件:
根据预处理后的文本生成bert文件。
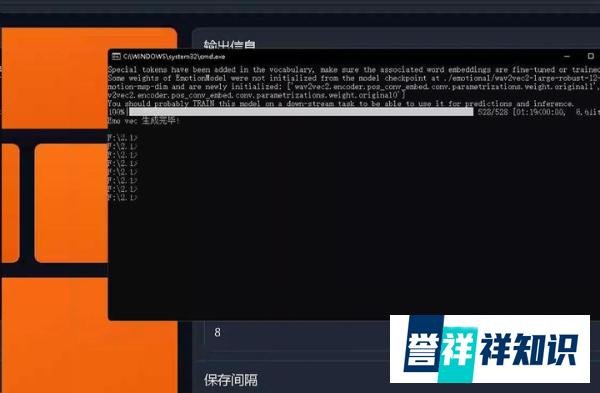
生成emo文件:
生成emo文件,用于情感文本转语音模型训练。
设置训练参数:
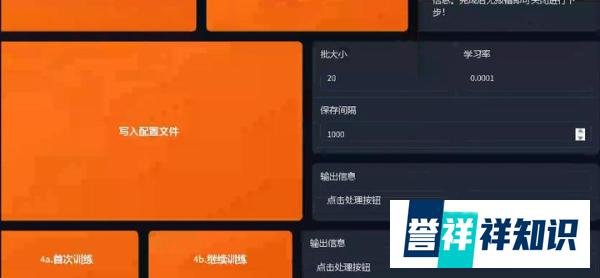
写入训练参数,如批大小,根据显卡设置,示例中设置为16。
开始训练:
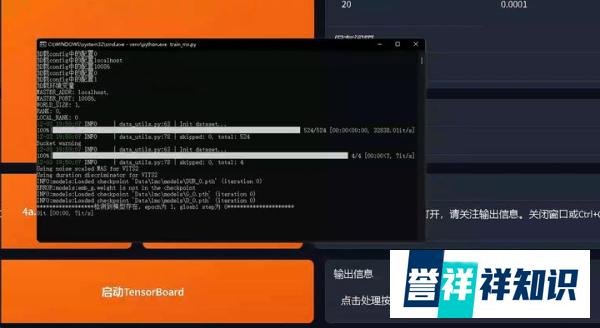
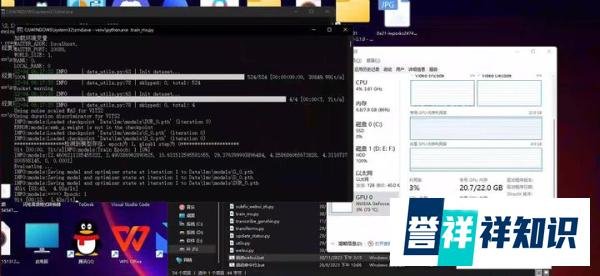
启动训练过程,等待模型训练完成。